ローカル環境でAIモデルを動かそうとする際、最大の障壁となるのがGPUのビデオメモリ(VRAM)容量です。パラメータ数が1,000億を超えるフロンティア級モデルを動かすには、従来であれば数十万円から数百万円規模のエンタープライズ向けGPU環境が必要でした。
この常識を覆す推論エンジンとして登場したのが「Strata」です。
Strataは、グラフィックスカードのVRAM、パソコン本体のメインメモリ(RAM)、そして高速NVMe SSDを統合的に活用することで、一般的なゲーミングPC環境であっても1,250億パラメータ規模の超巨大MoE(Mixture of Experts)モデルを実用的な速度で動作させます。
本記事では、Strataの動作原理、3層階層メモリの仕組み、既存エンジン(llama.cpp等)との性能比較、導入手順までを網羅して解説します。
Strataの概要と注目される理由
Strataは、開発者のNiko1221氏によってGitHub上で公開されたオープンソース(MITライセンス)のローカル推論エンジンです。
Alibabaのオープンモデル「Qwen3.8-Flash-Next」(約125Bパラメータ)などの大規模MoEモデルを、12GBから24GB程度のVRAMを搭載したコンシューマー向けGPUで実行することを目的に開発されました。
ローカル実行であるため、プロンプトや社内コードなどのデータが外部サーバーへ送信される心配がありません。
さらに、ローカルホスト上でOpenAI互換およびAnthropic互換のAPIエンドポイントを提供する設計となっており、既存のコーディングエージェントツールと容易に連携できます。
12GB VRAMで巨大MoEが動く仕組み:3層階層メモリ
なぜ、本来なら数百GBのメモリを要求する125Bモデルが、12GBのGPUで軽快に動作するのでしょうか。その理由は、MoEモデル特有の構造と、Strataが採用する「3層階層型メモリアーキテクチャ」にあります。
スパースMoEの局所性を活かすアプローチ
Qwen3.8-Flash-Nextは、48層のそれぞれに512個、全体で24,576個のエキスパートネットワークを持っています。しかし、1トークンを生成する際に実際に活性化されるのは各層わずか10個(全体の約2%)のみです。
さらに、会話やコード生成では「直前に使われたエキスパートが後続でも繰り返し使われる」という強い局所性(参照局所性)が存在します。Strataはこの特性を捉え、従来の「層ごと(Layer-wise)にモデルを分割する方式」を廃止し、「エキスパート単位」でメモリを柔軟に割り振る仕組みを構築しました。
3つの記憶領域を最適配分するトポロジー
Strataは、システム内の記憶リソースを役割に応じて明確に3段階へ分割しています。
- GPU VRAM(Hot Cache)毎トークン必ず使われるAttention層やルーター、KVキャッシュに加え、最も頻繁に呼び出されるエキスパート(Hot Experts)を配置します。VRAM容量が多いほど常駐できるエキスパートが増加し、後述するCPU処理が減るため速度が向上します。
- システムRAM(Pantry)量子化されたモデル全体の重み(約35〜50GB)を保持します。VRAMに収まらなかったColdエキスパートの演算は、CPUのAVX-512等のSIMD拡張命令を用いてメモリ上で並行処理します。
- NVMe SSD(Sparse Disk Page)約28.8GBにおよぶ巨大なn-gram参照テーブルや、必要時のメモリマップ重みを配置します。毎トークンで読み出すのはわずか十数行程度であるため、SSDへの負荷や遅延を抑えつつRAMの消費を劇的に節約します。
投機的デコーディングによる高速化
Strataは、モデルに組み込まれたMTP(Multi-Token Prediction)層を活用した投機的デコーディング(Speculative Decoding)を標準で統合しています。
VRAM上の軽量なドラフト機能が最大3トークン先までを予測し、本体の125Bモデルがそれを一括検証します。これにより、出力を1トークンも劣化させることなく、生成速度を1.6〜1.8倍に加速させています。
動作要件と推奨スペック
Strataの動作には、GPUのVRAMだけでなくPC全体のメモリ構成が重要となります。
| ハードウェア要素 | 最小要件 | 推奨要件(快適動作) |
| GPU | NVIDIA RTX 20/30/40/50シリーズ(VRAM 12GB以上) | NVIDIA RTX 3090 / 4070 Ti / 4080(VRAM 16〜24GB) |
| システムRAM | 32GB(Coder版や極小量子化のみ) | 64GB DDR5(全量子化サイズに対応) |
| ストレージ | NVMe SSD 空き容量 80GB以上 | 高速NVMe SSD 空き容量 100GB以上 |
| 対応OS | Windows 10/11, Linux | Windows 10/11, Linux |
※AMD Radeonシリーズ(HIP)やIntel Arc(Linux SYCL)、Apple Silicon Mac(Unified Memory 64GB以上)でも動作環境が提供されています。
既存エンジン(llama.cpp・vLLM)との性能比較
同一の量子化モデルファイル(IQ2_XS)を使用し、12GBクラスのGPU環境下で推論速度を比較した場合、Strataの特化型アーキテクチャが大きな強みを発揮します。
| 項目 | Strata LLM | llama.cpp | 備考 |
| デコード生成速度 | 約62.9〜94.6 tok/s | 約20.8〜23.4 tok/s | Strataが約2.7倍以上高速 |
| プロンプト読み込み | 最大2,726 tok/s | 約275 tok/s | プレフィル処理で約10倍の差 |
| 数学推論(GSM8K) | 93.3% | 93.0% | 精度に統計的差は見られない |
| コード生成(HumanEval) | 157 / 164問 | 157 / 164問 | 同等の正答数を記録 |
汎用エンジンのllama.cppは--cpu-moeオプション等でエキスパートをRAMへ退避できますが、推論ごとに全エキスパート計算をCPU側に任せるため、DDRメモリの帯域幅がボトルネックになります。
一方のStrataは、よく使われるエキスパートをVRAMのキャッシュに保持し続けるため、ホストメモリからの読み出し量そのものが削減され、圧倒的な高速化を実現しています。
Strataのインストールとクイックスタート
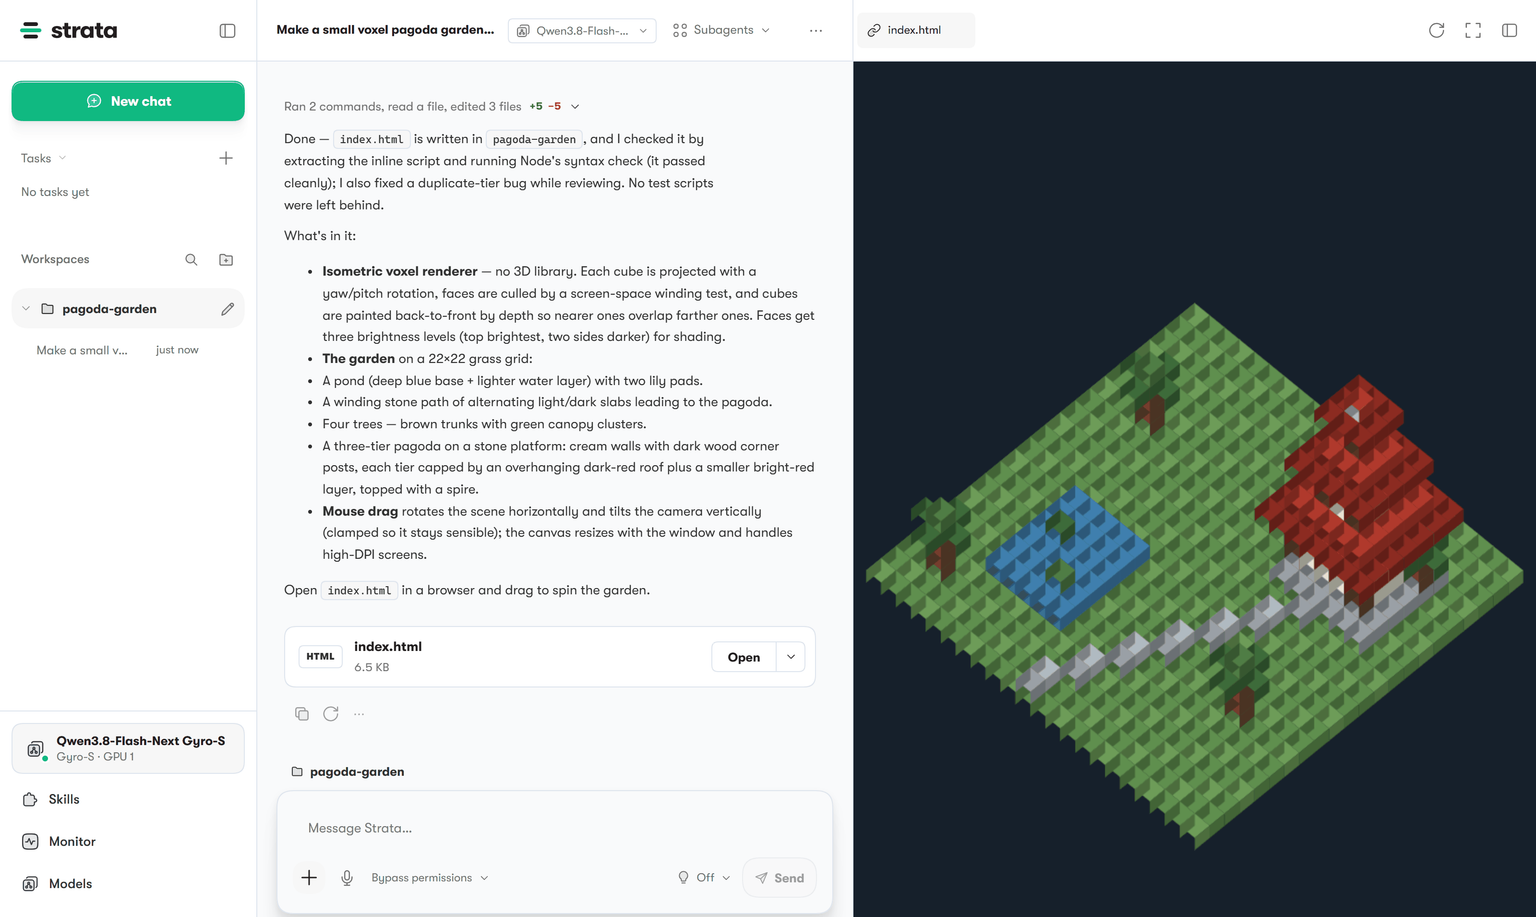
Strataは、コマンドライン(ターミナル)またはGUIインストーラーから手軽にセットアップ可能です。
導入コマンド
ターミナルから導入する場合、以下のコマンドを実行します。Python環境や対応エンジンの判別が自動で行われます。
Linux / macOS環境:
Bash
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh && sh install.sh
Windows(PowerShell)環境:
PowerShell
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex
起動と利用方法
インストール完了後、対話型UIを起動してモデルを選択します。
Bash
# 起動計画のみを確認(ダウンロードなし)
strata launch --plan

# 対話型画面でモデルを選択して起動
strata launch
起動後はブラウザからWebチャット画面([http://127.0.0.1:8080](http://127.0.0.1:8080))が利用できるほか、Claude CodeやOpenCodeなどの開発支援ツールにローカルエンドポイントを直接接続可能です。
Strataのメリットと導入前の注意点
メリット
- 圧倒的なコストパフォーマンス:高価なワークステーション用GPUを導入することなく、一般家庭のPCで100B超の知能を利用可能です。
- 完全なプライバシー保護:外部クラウドにコードや文章を一切送信しません。
- 開発ツールとの親和性:OpenAI/Anthropic互換APIにより、各種AIエージェントのバックエンドとして即座に機能します。
デメリット・注意点
- 初回ロードの待ち時間:起動時に数十GBのモデルデータをRAMとVRAMに配置・検証するため、初回起動に数分を要します。
- マルチユーザー同時接続の非効率性:個人デスクトップの単一処理に最適化されているため、複数人から同時に大量のリクエストを送る用途には適していません。
- 対応モデルの限定:llama.cppのようにあらゆるモデルを動かせるわけではなく、現時点ではQwen3.8-Flash-Nextなどの対応MoEモデルに特化しています。
まとめ
Strataは、「モデルのすべてをVRAMに載せなければならない」というこれまでのローカルLLM運用の常識を塗り替える画期的な推論エンジンです。
スパースMoEの局所性を徹底的に活かし、GPU・メインメモリ・SSDの各レイヤーを最適に組み合わせることで、12GBのグラフィックスカードでもストレスのない高速レスポンスを叩き出します。手元のゲーミングPCの性能を限界まで引き出し、プライベートかつ強力なAIアシスタントを構築したい開発者にとって、Strataは有力な選択肢となるでしょう。


